Domain uyak.de kaufen?
Wir ziehen mit dem Projekt
uyak.de um.
Sind Sie am Kauf der Domain
uyak.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain uyak.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **


Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
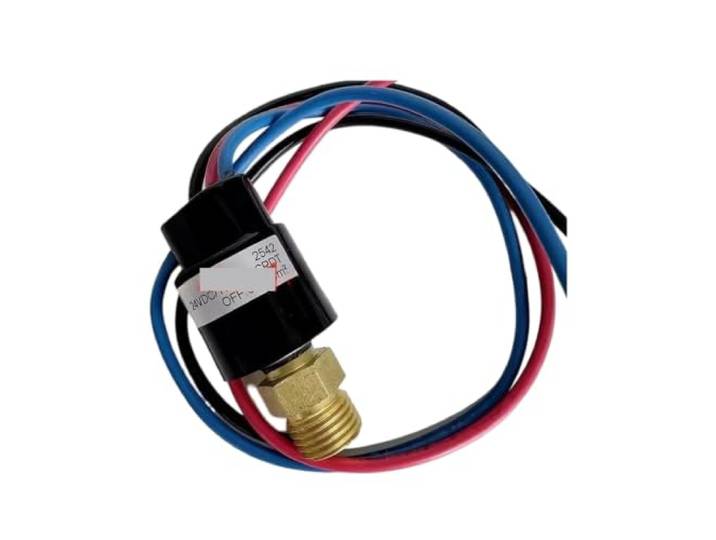
Hydrauliköldruckschaltersensor LF08 Luftkompressor-Controller Kompakt, Druckregelung, einfache Einrichtung, industrielle Automatisierung.Hydrauliköldruckschaltersensor LF08 Luftkompressor-Controller Kompakt, Druckregelung, einfache Einrichtung, industrielle Automatisierung.. Die einfache Installation ermöglicht eine unkomplizierte Montage und einen schnellen Austausch. Ausgestattet mit Messelementen zur Druckmessung, die eine langfristig stabile und zuverlässige Leistung in industriellen Anwendungen gewährleisten. Unterstützt mehrere Druckoptionen , geeignet für Luft, Wasser, Öl und andere industrielle Flüssigkeiten. Bequeme Installation und Integration, weitreichende Kompatibilität mit Steuerungen, Pumpen, Kompressoren und Automatisierungsgeräten. Ideal für HLK, Hydrauliksysteme, pneumatische Steuerungen und industrielle Automatisierung. Farbe:One Color200,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Chicco Digitaler Audio-Babymonitor, DECT-Technologie, Zwei-Wege-Kommunikation, 5 (Babyphone Audio, 300 m) (00011991000000)Chicco Digitaler Audio-Babymonitor, DECT-Technologie, Zwei-Wege-Kommunikation, 5 (Babyphone Audio, 300 m) (00011991000000)61,04 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Sungrow Kommunikation Datenlogger COM100DDie COM100D-EU Smart Communication Box enthält die Hardware- und Softwarefunktionen des Logger1000A-EU und unterstützt verschiedene Netzwerk-Verbindungsmöglichkeiten. Das äußerst zuverlässige Gerät bietet dedizierte Überspannungsschutzfunktionen und ist dank Schutzart IP 66 für eine Installation im Freien geeignet.614,03 €*Versand: 8,50 €Sichere Weiterleitung zum Anbieter
-
Hydrauliköldruckschaltersensor LF08 Luftkompressor-Controller Kompakt, Druckregelung, einfache Einrichtung, industrielle Automatisierung.Hydrauliköldruckschaltersensor LF08 Luftkompressor-Controller Kompakt, Druckregelung, einfache Einrichtung, industrielle Automatisierung.. Die einfache Installation ermöglicht eine unkomplizierte Montage und einen schnellen Austausch. Ausgestattet mit Messelementen zur Druckmessung, die eine langfristig stabile und zuverlässige Leistung in industriellen Anwendungen gewährleisten. Unterstützt mehrere Druckoptionen , geeignet für Luft, Wasser, Öl und andere industrielle Flüssigkeiten. Bequeme Installation und Integration, weitreichende Kompatibilität mit Steuerungen, Pumpen, Kompressoren und Automatisierungsgeräten. Ideal für HLK, Hydrauliksysteme, pneumatische Steuerungen und industrielle Automatisierung. Farbe:One Color200,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
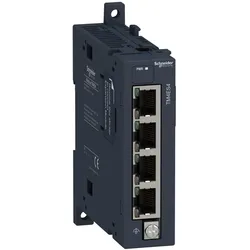
Schneider Electric Kommunikation TM4 Modul TM4ES4Anzahl der HW-Schnittstellen Industrial Ethernet=4Mit optischer Schnittstelle=neinUnterstützt Protokoll für EtherCAT=neinUnterstützt Protokoll für TCP/IP=jaUnterstützt Protokoll für PROFIBUS=neinUnterstützt Protokoll für CAN=neinUnterstützt Protokoll für INTERBUS=neinUnterstützt Protokoll für ASI=neinUnterstützt Protokoll für KNX=neinUnterstützt Protokoll für MODBUS=neinUnterstützt Protokoll für Data-Highway=neinUnterstützt Protokoll für DeviceNet=neinUnterstützt Protokoll für SUCONET=neinUnterstützt Protokoll für LON=neinUnterstützt Protokoll für PROFINET IO=neinUnterstützt Protokoll für PROFINET CBA=neinUnterstützt Protokoll für SERCOS=neinUnterstützt Protokoll für Foundation Fieldbus=neinUnterstützt Protokoll für EtherNet/IP=jaUnterstützt Protokoll für AS-Interface Safety at Work=neinUnterstützt Protokoll für DeviceNet Safety=neinUnterstützt Protokoll für INTERBUS-Safety=neinUnterstüt...133,09 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Schneider Electric Kommunikation TM4 Modul TM4PDPS1Anzahl der HW-Schnittstellen Industrial Ethernet=1Mit optischer Schnittstelle=neinUnterstützt Protokoll für EtherCAT=neinUnterstützt Protokoll für TCP/IP=neinUnterstützt Protokoll für PROFIBUS=jaUnterstützt Protokoll für CAN=neinUnterstützt Protokoll für INTERBUS=neinUnterstützt Protokoll für ASI=neinUnterstützt Protokoll für KNX=neinUnterstützt Protokoll für MODBUS=neinUnterstützt Protokoll für Data-Highway=neinUnterstützt Protokoll für DeviceNet=neinUnterstützt Protokoll für SUCONET=neinUnterstützt Protokoll für LON=neinUnterstützt Protokoll für PROFINET IO=neinUnterstützt Protokoll für PROFINET CBA=neinUnterstützt Protokoll für SERCOS=neinUnterstützt Protokoll für Foundation Fieldbus=neinUnterstützt Protokoll für EtherNet/IP=neinUnterstützt Protokoll für AS-Interface Safety at Work=neinUnterstützt Protokoll für DeviceNet Safety=neinUnterstützt Protokoll für INTERBUS-Safety=neinUnterst...227,36 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.